AI Token 是什么?大模型 Token 怎么计算与计费(附 Claude 示例)
AI Token 是什么意思?本文用通俗的话讲清大模型 Token 的含义、1 个 Token 约等于多少汉字和英文单词、Token 怎么计算与计费,并用 Claude API 的 usage 字段演示如何查看真实 Token 消耗,附 5 个减少 Token 消耗的方法。
SupaStore 开发者体验组 ·
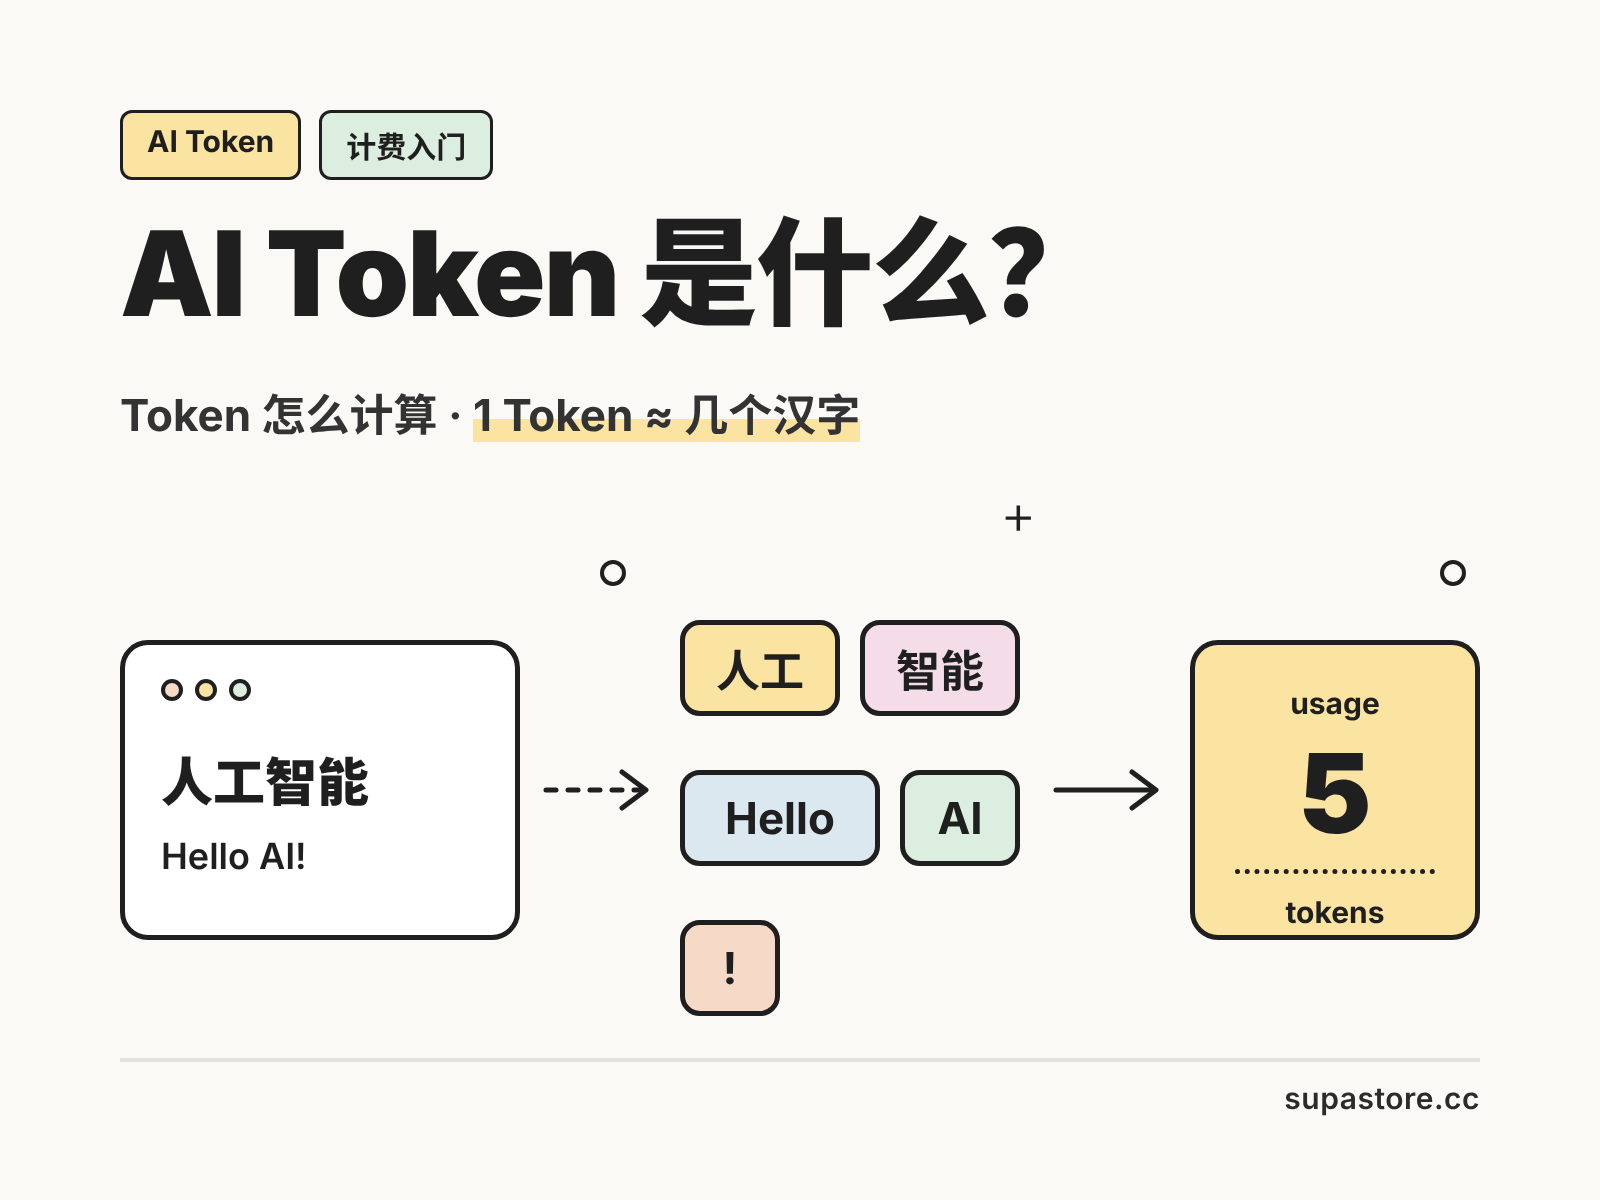
**AI Token 是什么?**简单说,Token 就是大模型读写文字的最小单位,也是 API 计费的单位。你发给模型的问题、模型回给你的答案,都会先被切成一个个 Token,再按 Token 数量收费。
搞懂 Token,你就能看懂各家模型的价格表,算出一次对话花了多少钱,也知道该从哪里省钱。本文用 Claude API 作为例子,讲清大模型 Token 怎么计算、Token 计费公式,以及怎样查看每次请求真实消耗的 Token 数。
AI Token 是什么意思
大模型不能直接理解文字,只能处理数字。所以文字进入模型之前,会先经过**分词器(Tokenizer)**切成小片段,每个片段对应一个编号,这些片段就是 Token。
举个例子,英文单词 unbelievable 可能被切成 un、believ、able 三个 Token;中文的"人工智能"可能是 2~4 个 Token,取决于模型的分词器。
Token 在大模型里有三个作用:
- 计费单位:API 按输入 Token 和输出 Token 数量收费。
- 长度单位:上下文窗口"1M"指模型一次最多能处理 100 万个 Token。
- 速度单位:输出速度通常用"Token / 秒"衡量,输出越长,等待越久。
1 个 Token 等于多少汉字和英文单词
Token 和字数之间没有固定的换算比例,只有经验值:
| 文本类型 | 经验换算 | 说明 |
|---|---|---|
| 英文 | 1 Token ≈ 4 个字符 ≈ 0.75 个单词 | 常见词通常是 1 个 Token |
| 中文 | 1 个汉字 ≈ 1~2 个 Token | 常用字、常用词更省,生僻字更多 |
| 代码 | 比同长度英文更多 | 缩进、符号、变量名都会占 Token |
| JSON / 表格 | 比纯文本更多 | 引号、括号、键名会被反复计算 |
所以估算时可以这样记:1,000 个汉字大约是 1,000~2,000 个 Token。要精确知道一段文本的 Token 数,只能用对应模型的分词器去数,或者看 API 返回的 usage 字段(后文有示例)。
Claude 新分词器:同样文字 Token 更多
不同模型的分词器不同,同一段话在不同模型里的 Token 数也不同。根据 Anthropic 官方说明,Claude 4.7 及之后的模型使用了新的分词器,同样的文本会多出约 30% 的 Token。比较新旧 Claude 模型的成本时,要把这一点算进去。
大模型 Token 怎么计算:四种 Token
一次 API 请求里,Token 分为四类,单价各不相同:
1. 输入 Token
你发给模型的所有内容都算输入 Token,不只是你打的那句话,还包括:
- 系统提示词(system prompt);
- 多轮对话中之前所有的问答历史;
- 工具定义(tools)和工具调用返回的结果;
- 上传的文件、图片(图片也会折算成 Token)。
这就是为什么对话越长越贵:每一轮请求都会把前面的历史重新发送一遍。
2. 输出 Token
模型生成的回答。输出 Token 的单价通常是输入的数倍,Claude 全系列都是 5 倍。开启思考(thinking)时,模型的思考过程同样按输出 Token 计费。
3. 缓存写入 Token
开启 Prompt 缓存后,第一次把一段固定前缀写入缓存,这部分按缓存写入价计费,比普通输入略贵。
4. 缓存命中 Token
之后的请求如果前缀完全一致,就会命中缓存,按很低的价格计费。以 Claude Sonnet 5.5 为例,缓存命中价只有普通输入的 5%。
如何查看每次请求的真实 Token 消耗
最准确的 Token 计算方法,是直接看 API 返回的 usage 字段。下面用 Claude 原生 Messages 接口发一个请求:
curl https://api.supastore.cc/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: sk-your-supastore-api-key" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-4-6",
    "max_tokens": 1024,
    "messages": [{"role": "user", "content": "用一句话解释什么是 Token"}]
  }'
返回结果的末尾会有类似这样的 usage:
{
  "usage": {
    "input_tokens": 21,
    "cache_creation_input_tokens": 0,
    "cache_read_input_tokens": 0,
    "output_tokens": 48
  }
}
四个字段正好对应上面的四种 Token:input_tokens 是普通输入,cache_creation_input_tokens 是缓存写入,cache_read_input_tokens 是缓存命中,output_tokens 是输出。在 SupaStore 控制台的使用日志里,也能逐条看到每次请求的 Token 数和扣费金额。
Token 计费公式:一次对话花多少钱
知道了 Token 数,套用下面的公式就能算出费用:
费用 = 普通输入 Token × 输入单价
     + 缓存写入 Token × 缓存写入单价
     + 缓存命中 Token × 缓存命中单价
     + 输出 Token     × 输出单价
(单价单位:美元 / 百万 Token)
实例:一篇 2,000 字中文文章的 Token 计费
用 claude-sonnet-4-6 把一篇约 2,000 字的中文文章总结成 300 字:
- 输入:文章 + 指令约 3,000 Token;
- 输出:300 字摘要约 450 Token。
按 Anthropic 官方价(输入 $3、输出 $15 / 百万 Token):
输入:3,000 × $3  / 1M = $0.0090
输出:  450 × $15 / 1M = $0.00675
合计 ≈ $0.0158,约 0.11 元人民币
单次看起来很便宜,但批量处理一万篇文章就是 $158。各个 Claude 模型的单价和完整收费标准,见《Claude API 价格是多少?2026 Claude API 收费标准》。如果你用的是 API中转站,价格页上显示的可能是"倍率",换算方法见《API中转站倍率是什么意思?》。
上下文窗口也是按 Token 计算的
"上下文窗口"指模型单次请求能处理的最大 Token 数,输入和输出加起来都不能超过它。目前 Claude 4.6 及之后的主力模型支持 1M(100 万)Token 的上下文窗口,大约能放下几十万字的中文文档或一个中型代码仓库。
不过,上下文能放得下不代表应该全放进去:每多放一个 Token,每轮请求都要为它付费。
减少 Token 消耗的 5 个方法
- 固定内容放前面,开启缓存:系统提示词、工具定义、参考文档放在请求开头并打上
cache_control,重复调用时按缓存价计费。 - 长对话及时新开:历史越长,每轮重复发送的输入 Token 越多。换话题就开新会话。
- 限制输出长度:在提示词里写清"200 字以内",或设置合理的
max_tokens,避免模型写一大段你不需要的内容。 - 精简上下文:编程工具里排除
node_modules、构建产物和日志;RAG 只检索最相关的几段,而不是整篇文档。 - 简单任务用小模型:分类、提取、格式转换用 Haiku 这类小模型,Token 单价可以低一个数量级。
在 Claude Code 里怎么配置 Claude API 并利用缓存省钱,见《Claude API 中转怎么用?Claude Code 中转站配置教程》;更多模型的价格对比见《2026 主流大模型价格对比与企业 API 成本优化指南》。
常见问题 (FAQ)
Q: Token 和字数是一回事吗?
答: 不是。Token 是分词器切出来的片段,一个 Token 可能是一个字、半个词,也可能是一个标点。中文 1 个汉字大约对应 1~2 个 Token,具体以模型的分词器为准。
Q: 为什么输出 Token 比输入 Token 贵?
答: 输入可以并行处理,输出要一个 Token 一个 Token 地依次生成,占用的算力和时间更多,所以单价更高。Claude 全系列的输出单价都是输入的 5 倍。
Q: 图片会消耗 Token 吗?
答: 会。图片会按分辨率折算成输入 Token,分辨率越高,Token 越多。只需要模型看清大致内容时,先压缩图片再上传可以省下不少 Token。
Q: 同一个问题,为什么每次消耗的 Token 不一样?
答: 输入 Token 一般是固定的,但输出 Token 取决于模型每次生成的内容长度;开启思考时,思考的长度也会变化。另外,多轮对话中历史越长,输入 Token 也会越多。