Claude API 流式输出怎么做?Claude Streaming 教程(Python / Node.js / SSE 事件详解)
Claude API 流式输出怎么做?这篇 Claude Streaming 教程用 Python 和 Node.js 演示 Claude 流式输出的写法,讲清 SSE 事件类型(message_start、content_block_delta、message_stop 等)、思考内容与工具调用的流式处理、获取最终 usage 的方法,以及流中途报错和超时的处理方式。
SupaStore 开发者体验组 ·
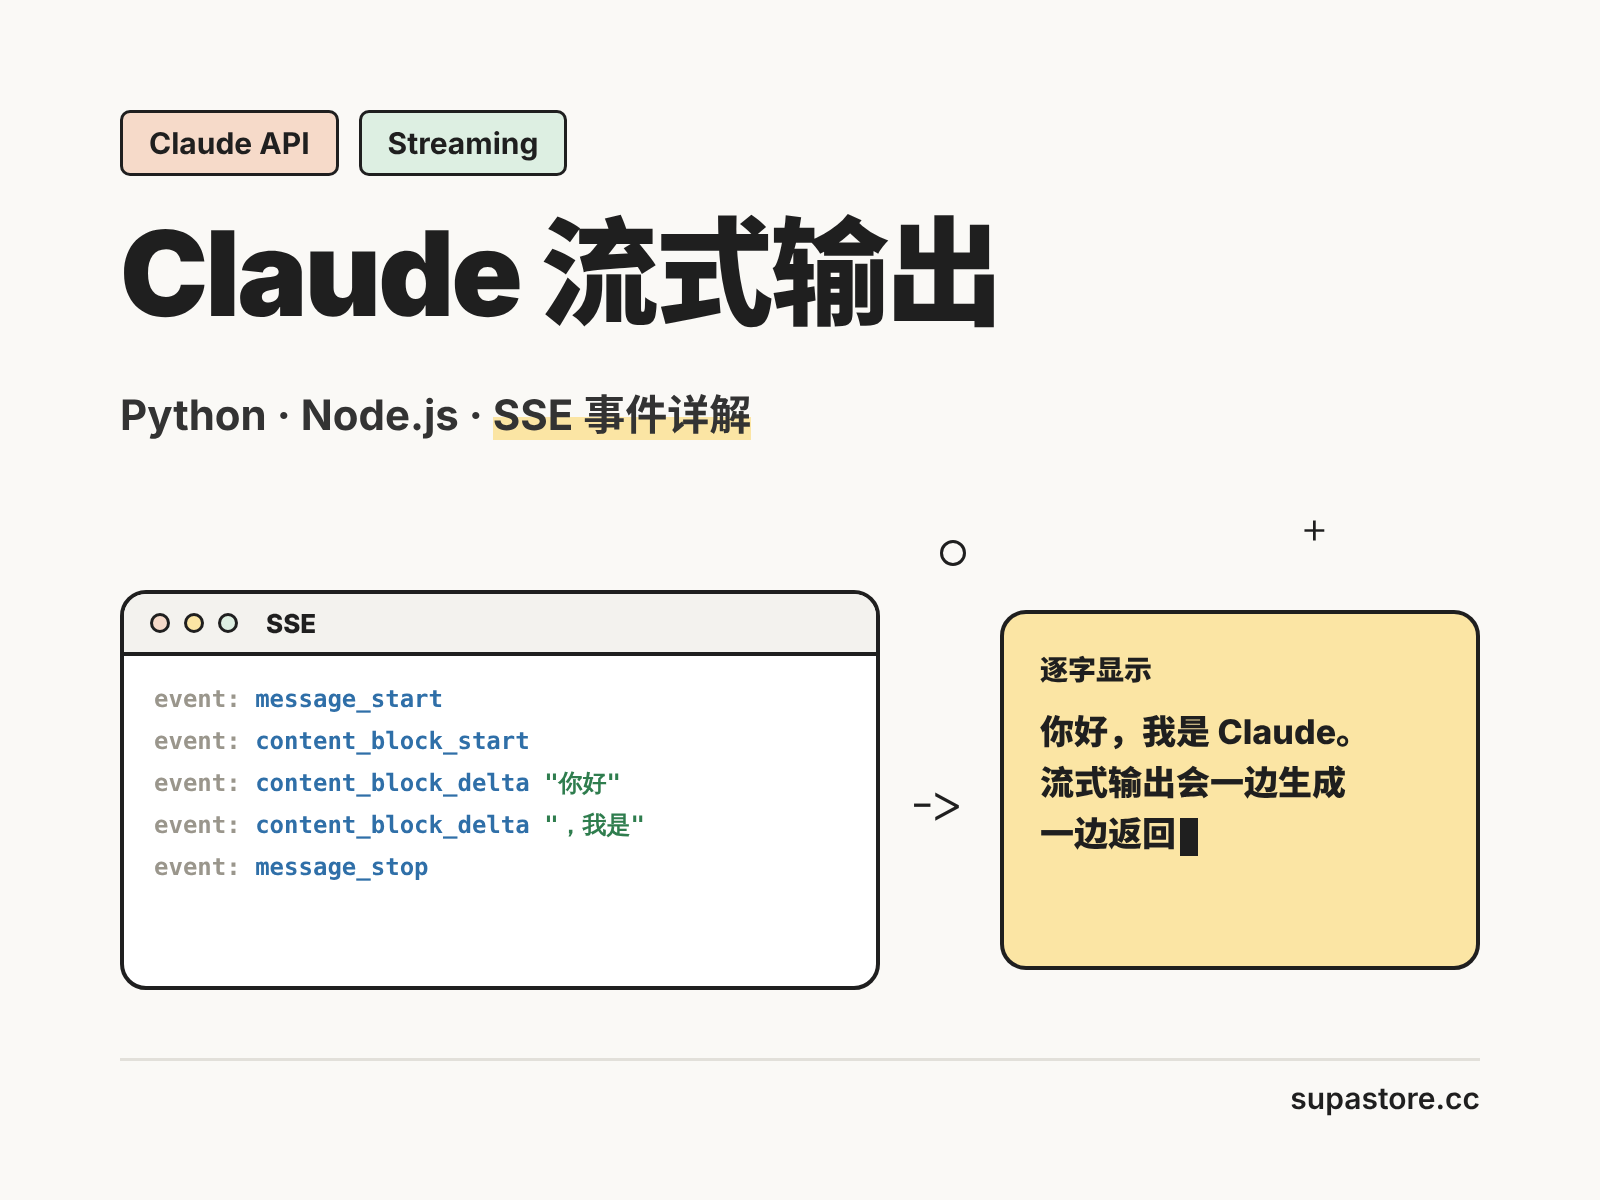
Claude API 流式输出(Streaming)让 Claude 边生成边返回,用户在第一个字生成出来时就能看到内容,不用等整段回答写完。聊天界面、长文生成、代码助手都离不开 Claude 流式输出;而当 max_tokens 设得很大时,SDK 甚至会要求你必须用流式请求,以免连接超时。
这篇 Claude Streaming 教程用 Python 和 Node.js 演示流式输出的写法,讲清底层的 SSE 事件,以及思考内容、工具调用和报错在流式模式下怎么处理。基础调用方法见《Claude API 调用教程:Python 接入 Claude API 完整示例》。
什么时候需要 Claude 流式输出
| 场景 | 是否推荐流式 |
|---|---|
| 聊天界面、写作助手,需要逐字显示 | 推荐 |
长篇生成、max_tokens 很大 |
必须,否则容易超时 |
| 开启思考,想实时展示思考进度 | 推荐 |
| 后台批量处理、不需要实时展示 | 不需要,考虑用 Batch API |
不需要实时展示的离线任务,用批处理更省钱,见《Claude Batch API 怎么用?》。
Python 实现 Claude 流式输出
最简单的写法:text_stream
import anthropic

client = anthropic.Anthropic(base_url="https://api.supastore.cc/v1")

with client.messages.stream(
    model="claude-sonnet-5-5",
    max_tokens=64000,
    messages=[{"role": "user", "content": "写一篇 800 字的 Python 入门指南"}],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)

    final = stream.get_final_message()

print()
print("输出 Token:", final.usage.output_tokens)
text_stream 只返回文字片段;结束后用 get_final_message() 拿到完整消息和 usage,用来计算这次请求的费用。
底层写法:stream=True
只需要原始事件、想自己处理时,可以给 messages.create 传 stream=True:
for event in client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=64000,
    messages=[{"role": "user", "content": "你好"}],
    stream=True,
):
    if event.type == "content_block_delta" and event.delta.type == "text_delta":
        print(event.delta.text, end="", flush=True)
这种写法不会自动拼接最终消息,需要完整结果时推荐用上面的 messages.stream。
Node.js 实现 Claude 流式输出
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({ baseURL: "https://api.supastore.cc/v1" });

const stream = client.messages.stream({
  model: "claude-sonnet-5-5",
  max_tokens: 64000,
  messages: [{ role: "user", content: "用三段话介绍 TypeScript" }],
});

stream.on("text", (text) => process.stdout.write(text));

const message = await stream.finalMessage();
console.log("\n输出 Token:", message.usage.output_tokens);
stream.on("text", ...) 逐段拿到文字,await stream.finalMessage() 拿到完整消息,不需要自己用 Promise 包装事件。
Claude 流式输出的 SSE 事件详解
在 HTTP 层面,流式响应是一串 SSE(Server-Sent Events)事件,顺序如下:
| 事件 | 含义 |
|---|---|
message_start |
消息开始,包含模型和初始 usage |
content_block_start |
一个内容块开始:text、thinking 或 tool_use |
content_block_delta |
内容块的增量:text_delta、thinking_delta、input_json_delta |
content_block_stop |
当前内容块结束 |
message_delta |
消息级更新,包含 stop_reason 和最终的输出 Token 数 |
message_stop |
整条消息结束 |
ping |
保活事件,可以忽略 |
error |
流中途出错 |
用 cURL 可以直接看到原始事件:
curl https://api.supastore.cc/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 1024,
    "stream": true,
    "messages": [{"role": "user", "content": "你好"}]
  }'
流式输出中的思考与工具调用
显示思考内容
新一代模型的思考默认不返回思考文字(display 为 omitted),流式时会看到一段停顿后才开始输出正文。想实时展示思考摘要,设置 display: "summarized":
with client.messages.stream(
    model="claude-sonnet-5-5",
    max_tokens=64000,
    thinking={"type": "adaptive", "display": "summarized"},
    messages=[{"role": "user", "content": "分析这道题的解法"}],
) as stream:
    for event in stream:
        if event.type == "content_block_delta":
            if event.delta.type == "thinking_delta":
                print(event.delta.thinking, end="", flush=True)
            elif event.delta.type == "text_delta":
                print(event.delta.text, end="", flush=True)
思考的设置和计费见《Claude 思考模式怎么用?Adaptive Thinking 与 effort 参数详解》。
工具调用的流式参数
工具调用时,参数以 input_json_delta 片段逐步返回。工具参数很长(比如要写入整个文件)时,可以在工具定义里加 "eager_input_streaming": True,让参数一边生成一边推送;此时 API 不再预先校验参数,拿到完整参数后要自己校验再执行。工具调用的完整流程见《Claude 工具调用怎么用?Claude Function Calling 教程》。
流式输出的报错与超时
- 流中途出错:流式响应先返回 200,之后可能在中途收到
error事件(例如overloaded_error),这时不会走普通的 HTTP 错误处理,需要在事件循环里捕获并重试; - 检查 stop_reason:
max_tokens表示输出被截断,需要调大max_tokens; - 网络断开:长时间的流式连接可能被中间网络断开,SDK 默认会对连接错误重试;
- 非流式超时:非流式请求预计超过 10 分钟时,SDK 会直接要求改用流式。
错误码的完整说明见《Claude API 报错怎么办?2026 Claude API 错误码大全》。通过中转站使用时,要确认服务商支持 SSE 流式透传,不会缓冲整段响应后再返回。
常见问题 (FAQ)
Q: Claude API 怎么开启流式输出?
答: Python SDK 使用 client.messages.stream 并遍历 text_stream,Node.js SDK 使用 client.messages.stream 并监听 text 事件;直接调用 HTTP 接口时在请求体中设置 stream 为 true。
Q: 流式输出怎么拿到 Token 用量?
答: 流结束后调用 Python 的 get_final_message 或 Node.js 的 finalMessage,从返回消息的 usage 字段读取输入和输出 Token;底层事件中 message_delta 也会带上最终的输出 Token 数。
Q: 为什么开启思考后流式输出要等很久才出字?
答: 新一代模型默认不返回思考文字,思考期间不会推送内容;在 thinking 参数中设置 display 为 summarized,就能实时看到思考摘要。
Q: 流式输出和非流式输出价格一样吗?
答: 一样,两者都按实际的输入和输出 Token 计费,流式输出只是改变了返回方式,不会额外收费。
Q: 流式输出中途报错怎么办?
答: 流式响应可能在返回 200 之后才收到 error 事件,需要在遍历事件时捕获异常,对 overloaded_error 等临时错误进行重试,对请求参数错误则需要修改请求。