Claude Prompt 缓存怎么用?Prompt Caching 教程:cache_control 用法与命中率优化
Claude Prompt 缓存怎么用?这篇 Prompt Caching 教程讲清缓存的计费方式和回本条件,演示 cache_control 自动缓存与手动断点两种写法,说明 5 分钟和 1 小时 TTL 怎么选、最小缓存长度,并列出让缓存失效的常见原因和提高缓存命中率的方法,帮你把 Claude API 输入成本降到原来的零头。
SupaStore 成本优化实验室 ·
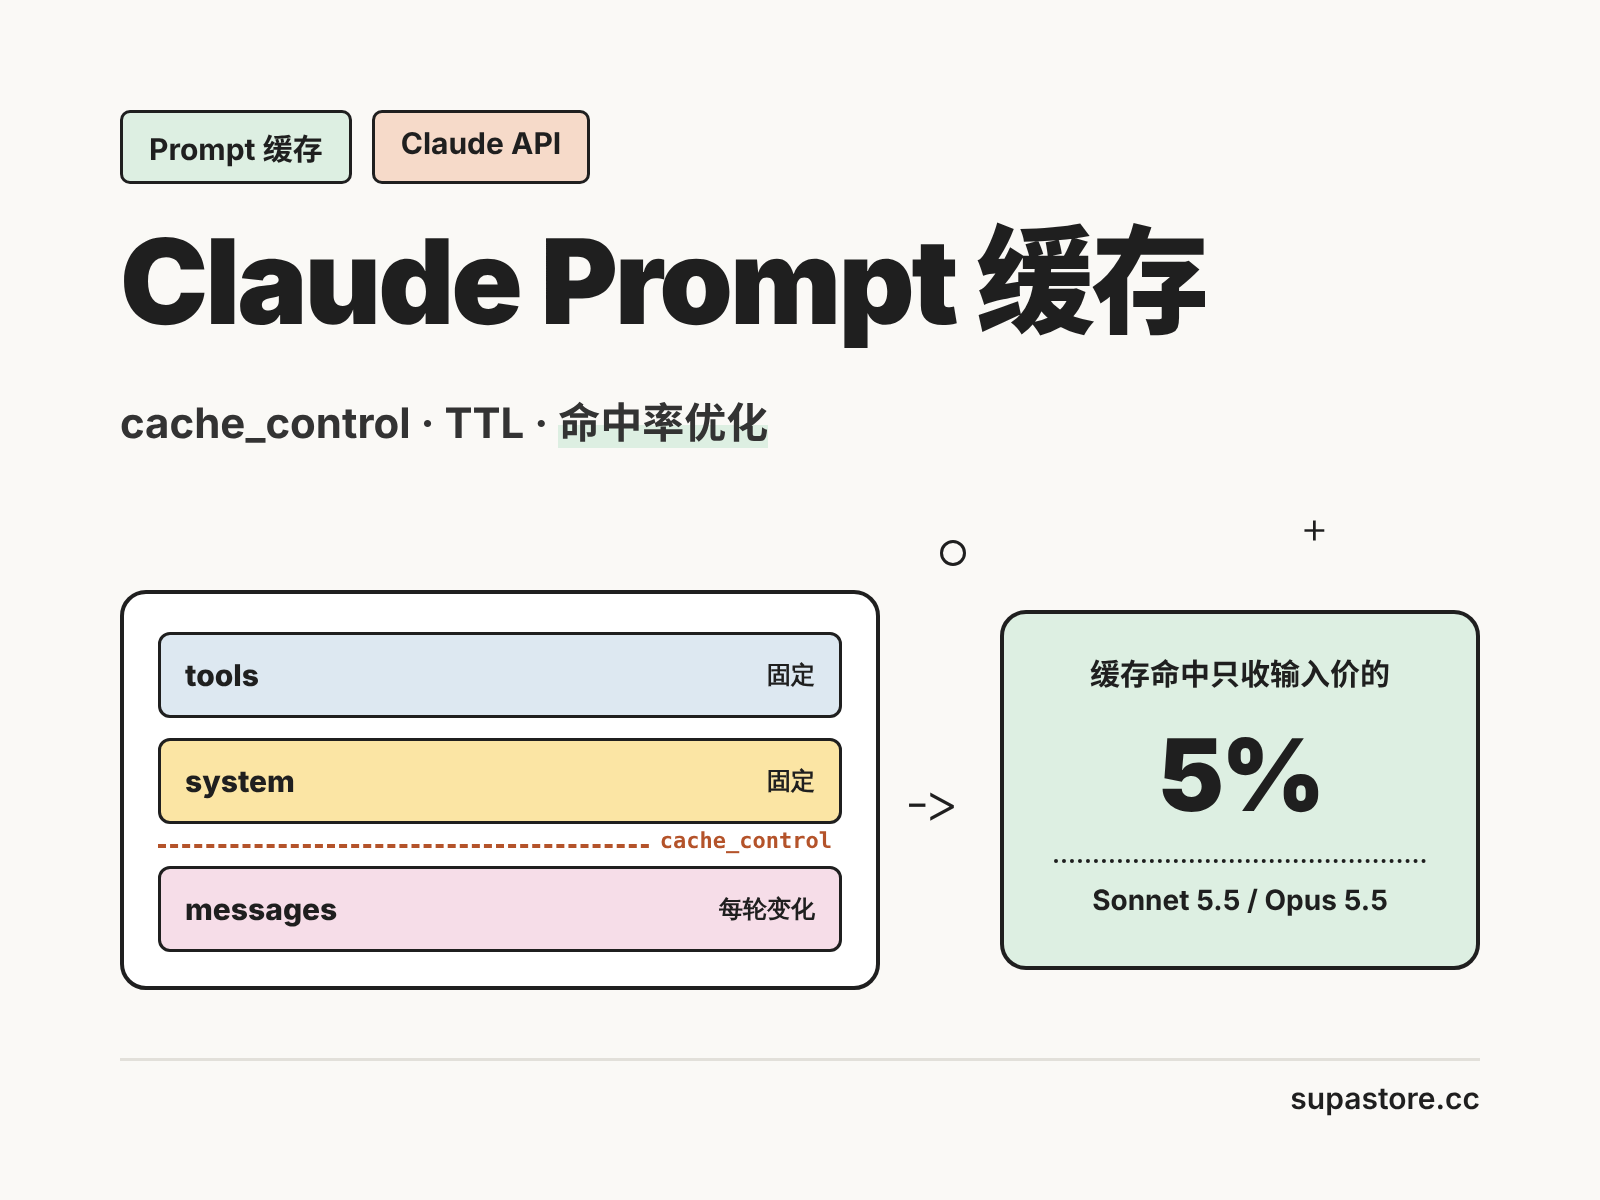
Claude Prompt 缓存(Prompt Caching)是降低 Claude API 成本最有效的手段:把每次请求都重复发送的系统提示词、工具定义、长文档缓存起来,下次命中时只按输入价的 5%~10% 计费。对 Claude Code、Agent、知识库问答这类上下文很长的场景,开不开缓存,账单能差好几倍。
这篇 Prompt Caching 教程讲清 Claude Prompt 缓存怎么计费、什么时候回本,演示 cache_control 的两种写法,再说明怎样避免缓存失效、提高缓存命中率。各模型的基础单价见《Claude API 价格是多少?2026 Claude API 收费标准与省钱指南》。
Claude Prompt 缓存是什么
Claude 的 Prompt 缓存按前缀匹配:请求按 tools → system → messages 的顺序拼成一个完整提示,你在某个位置打上缓存断点,断点之前的内容就会被缓存。下一次请求只要断点之前的内容一个字节都不变,就能命中缓存。
缓存有效期默认 5 分钟,每次命中都会免费续期;也可以选择 1 小时有效期。
Claude Prompt 缓存怎么计费
| 计费项 | 相对普通输入价 | 以 Sonnet 5.5 为例(每百万 Token) |
|---|---|---|
| 普通输入 | 1 倍 | $2 |
| 缓存写入(5 分钟) | 1.25 倍 | $2.5 |
| 缓存写入(1 小时) | 2 倍 | $4 |
| 缓存命中 | 0.1 倍(Opus 5.5 / Sonnet 5.5 为 0.05 倍,Fable 5.1 为 0.025 倍) | $0.1 |
缓存什么时候回本
- 5 分钟缓存:写入多付 25%,只要被读取 1 次就回本;
- 1 小时缓存:写入多付 100%,至少要被读取 2 次才划算。
以 Sonnet 5.5、一段 5 万 Token 的固定系统提示为例,连续调用 10 次:
不开缓存:50,000 × 10 × $2 / 1M            = $1.00
开缓存:  50,000 × $2.5 / 1M(首次写入)
        + 50,000 × 9 × $0.1 / 1M(9 次命中)≈ $0.17
同样的请求,费用降到原来的约 1/6。Token 和 usage 字段的基础概念见《AI Token 是什么?大模型 Token 怎么计算与计费》。
cache_control 怎么用:两种写法
写法一:自动缓存(推荐)
在请求顶层加一个 cache_control,系统会自动把断点放在最后一个可缓存的内容块上,并随着对话增长自动前移,最适合多轮对话:
import anthropic

client = anthropic.Anthropic(base_url="https://api.supastore.cc/v1")

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    cache_control={"type": "ephemeral"},
    system="你是 SupaStore 的客服助手……(这里是很长且固定的说明)",
    messages=[{"role": "user", "content": "怎么创建 API Key?"}],
)
写法二:手动设置缓存断点
当提示词末尾是每次都不同的内容(检索到的文档、用户问题)时,自动断点会落在这些"一次性"内容之后,每次都付写入费却读不回来。这时应在固定部分的末尾手动打断点:
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=16000,
    system=[
        {
            "type": "text",
            "text": long_product_manual,          # 固定不变的长文档
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[{"role": "user", "content": user_question}],  # 每次不同
)
一个请求最多可以设置 4 个缓存断点。工具定义很少变、系统提示偶尔变、对话每轮都变时,可以在每个"稳定边界"各放一个断点。
5 分钟还是 1 小时:缓存 TTL 怎么选
| 两次请求的间隔 | 推荐 TTL | 原因 |
|---|---|---|
| 小于 5 分钟(连续对话、Agent 循环、批量处理) | 5 分钟(默认) | 每次命中都会续期,缓存一直有效 |
| 5 分钟~1 小时(用户隔一会儿才回复) | 1 小时 | 写入贵一倍,但能避免过期后整段重新写入 |
| 超过 1 小时 | 不必强求 | 缓存大概率已过期 |
使用 1 小时缓存时,在 cache_control 里加上 ttl:
"cache_control": {"type": "ephemeral", "ttl": "1h"}
为什么缓存没命中:7 个常见原因
- 前缀太短:当前模型(Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5)至少 512 Token 才能缓存,更短的内容即使打了断点也不会缓存,也不会报错。
- 系统提示里有动态内容:当前时间、请求 ID、用户名写在
system开头,每次都不同,后面的缓存全部失效。动态内容要放到最后一个断点之后。 - 工具定义变了:增删、改名或调整工具顺序,会让整个缓存失效。工具列表要固定,并按名称排序后再序列化。
- 切换了模型:缓存按模型隔离,同一会话里来回换模型无法复用缓存。
- 改了思考或 effort 设置:修改 thinking 配置或
effort,消息部分的缓存会失效,按场景固定这两个参数。 - 并发请求太早:缓存条目要等第一个响应开始后才可用,并行请求想命中缓存,先等第一个请求返回。
- JSON 序列化不稳定:字典键顺序每次不同,内容看起来一样,字节却不一样。
怎么查看 Claude 缓存命中率
每次响应的 usage 字段会返回三项输入 Token:
u = response.usage
print("缓存写入:", u.cache_creation_input_tokens)
print("缓存命中:", u.cache_read_input_tokens)
print("普通输入:", u.input_tokens)

hit_rate = u.cache_read_input_tokens / (
    u.cache_read_input_tokens + u.cache_creation_input_tokens + u.input_tokens
)
print(f"缓存命中率: {hit_rate:.0%}")
健康的多轮对话里,每次请求应该读取之前的全部内容、只写入新增的一轮。如果连续几次 cache_read_input_tokens 都是 0,就说明前缀被改动了,按上面 7 个原因逐一排查。
Claude Code 与中转站的 Prompt 缓存
Claude Code 会自动使用 Prompt 缓存,不需要手动设置。在会话中运行 /usage,Prompt cache (main) 一行会显示缓存命中比例、未命中次数和缓存是否仍然有效。离开超过缓存有效期再回来,第一条消息会重新写入整段上下文,这也是 Claude Code Token 消耗突然变高的常见原因,详见《Claude Code Token 消耗太快?10 个 Claude Code 省 Token 技巧》。
通过 API中转站调用时,要确认两件事:中转站是否完整透传 cache_control 字段,以及缓存 Token 是否按缓存价计费。有的中转站把缓存命中按普通输入价收费,开了缓存也省不了钱。检测方法见《API中转站是什么?AI中转站选型避坑指南》,缓存价格的换算见《API中转站倍率是什么意思?》。
常见问题 (FAQ)
Q: Claude Prompt 缓存能省多少钱?
答: 缓存命中部分只按输入价的 10% 计费,Opus 5.5 和 Sonnet 5.5 为 5%,Fable 5.1 为 2.5%;固定上下文占比越高、重复调用越频繁,省得越多,常见场景能把输入成本降到原来的几分之一。
Q: Claude Prompt 缓存有效期多久?
答: 默认 5 分钟,每次命中会免费续期;也可以在 cache_control 中设置 ttl 为 1h 使用 1 小时缓存,写入价格为普通输入的 2 倍。
Q: 为什么设置了 cache_control 还是没有缓存?
答: 最常见的原因是缓存前缀不足最小长度,当前模型至少需要 512 Token;其次是断点之前的内容每次都在变化,例如系统提示里包含当前时间或请求 ID。
Q: 一个请求最多能设置几个缓存断点?
答: 最多 4 个,顶层自动缓存也会占用其中一个,通常一个放在固定系统提示末尾、一个交给自动缓存跟随对话增长就足够了。
Q: 不同 API Key 之间的缓存能共享吗?
答: 缓存在不同组织之间完全隔离,在 Claude API 上同一组织的不同工作区之间也相互隔离,相同的提示词在不同工作区会分别写入缓存。