Claude 怎么读取 PDF?Claude API 上传 PDF 与文档解析教程(附费用估算)
Claude 怎么读取 PDF?本文讲清 Claude API 上传 PDF 的原理与页数、大小限制,用 base64、URL 和 OpenAI SDK 三种方式演示 Claude PDF 解析,估算每页 Token 与读取一份 PDF 的费用,并给出长 PDF 拆分、Prompt 缓存省钱和常见报错排查方法。
SupaStore 开发者体验组 ·
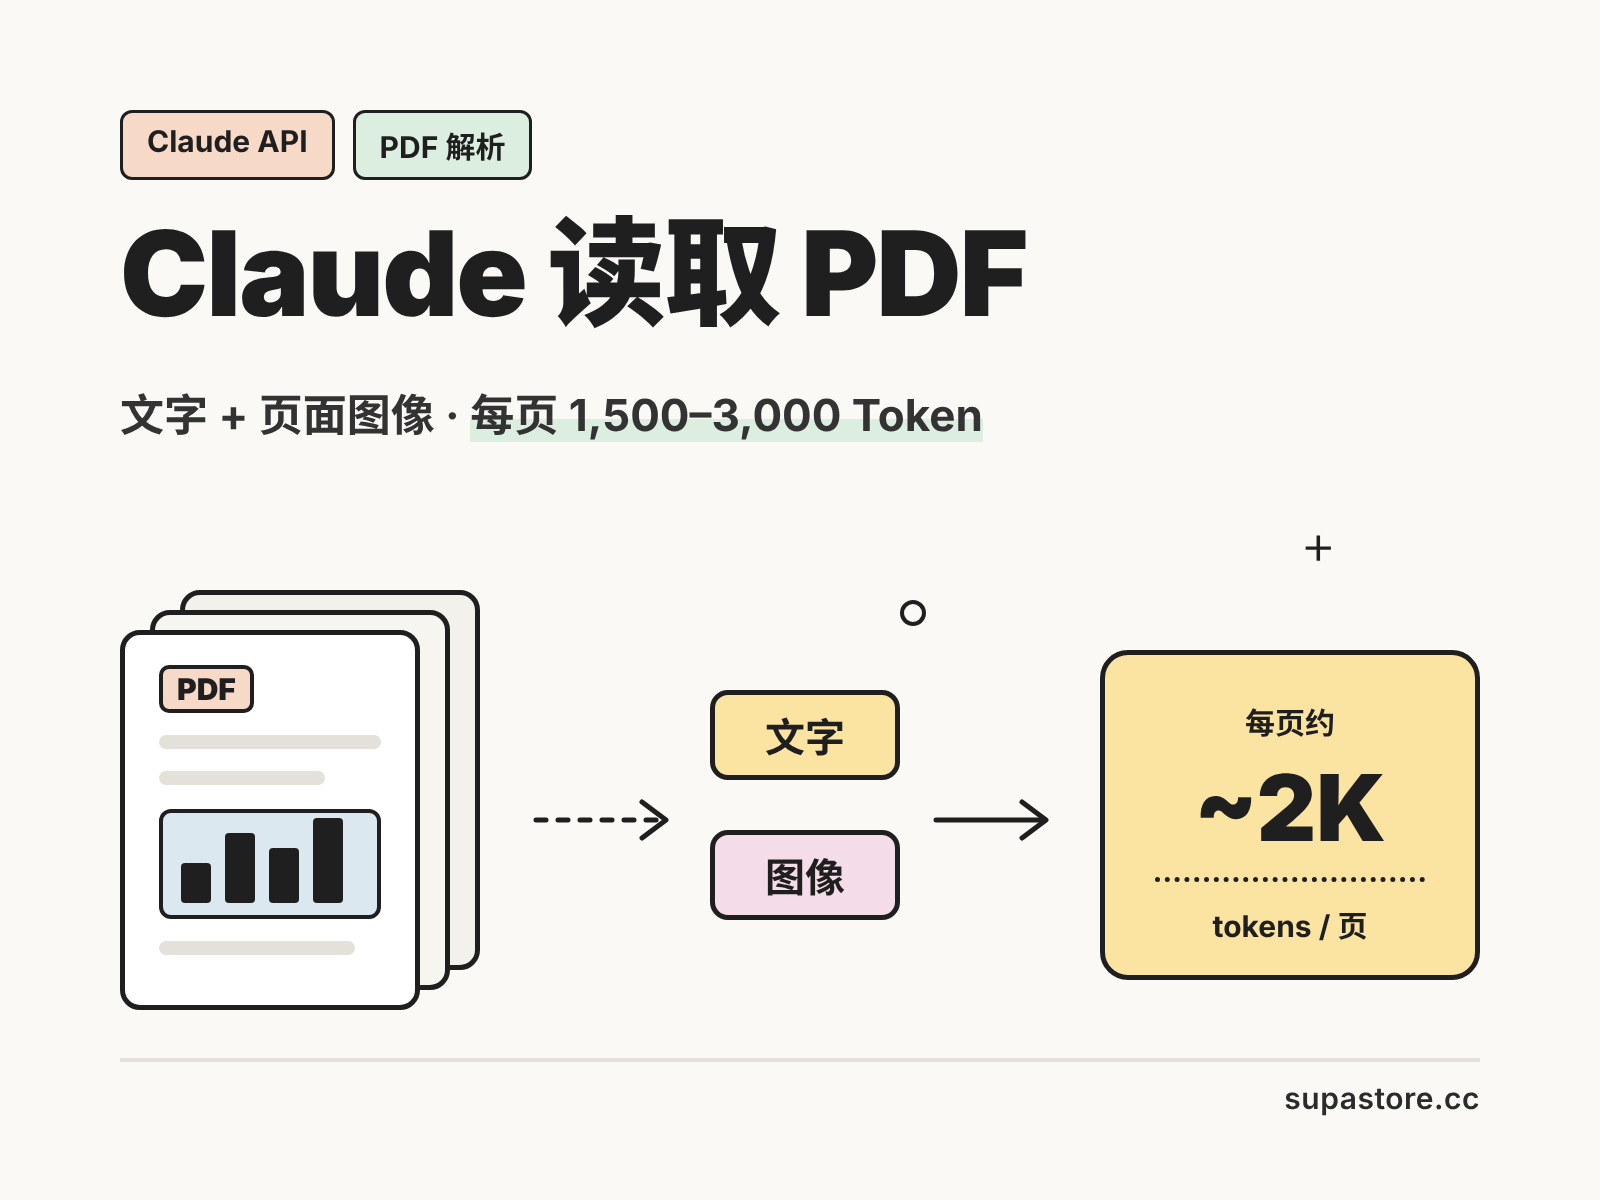
Claude 读取 PDF 不需要先用工具把 PDF 转成文字:在 Claude API 的消息里放一个 document 内容块,Claude 就能直接分析 PDF 里的文字、表格、图表和图片。财报分析、合同条款提取、论文总结、扫描件识别,都可以用同一套写法完成。
本文讲清 Claude PDF 解析的原理和限制,用三种方式演示 Claude API 上传 PDF,再估算读取一份 PDF 要花多少钱。图片的识别方式与之类似,见《Claude 图片识别怎么用?Claude Vision API 教程》。
Claude 读取 PDF 的原理
Claude 处理 PDF 时,每一页会同时提供两种信息:
- 页面文字:从 PDF 中提取出的文本;
- 页面图像:把整页渲染成一张图片。
所以 Claude 不只是"读字",还能看懂排版、表格、图表和插图。扫描件里没有可提取的文字层,Claude 也能通过页面图像识别内容。代价是:每一页既要算文字 Token,也要算图片 Token。
Claude PDF 支持的限制
| 项目 | 限制(Claude API) |
|---|---|
| 整个请求体 | 不超过 128 MB |
| 单次请求页数 | 最多 600 页;请求的上下文窗口小于 1M Token 时最多 100 页 |
| 文件格式 | 标准 PDF,不能加密或设置密码 |
| 支持的模型 | 所有在售的 Claude 模型 |
页数上限和上下文窗口有关,关于 1M 上下文的说明见《Claude 上下文窗口多大?》。
方法一:base64 上传 PDF(Claude 原生接口)
把本地 PDF 编码成 base64,放进 document 内容块:
PDF_B64=$(base64 < report.pdf | tr -d '\n')

curl https://api.supastore.cc/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $SUPASTORE_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d @- <<EOF
{
  "model": "claude-sonnet-4-6",
  "max_tokens": 2048,
  "messages": [{
    "role": "user",
    "content": [
      {
        "type": "document",
        "source": {"type": "base64", "media_type": "application/pdf", "data": "$PDF_B64"}
      },
      {"type": "text", "text": "用 5 条要点总结这份报告,并列出所有出现的金额"}
    ]
  }]
}
EOF
和图片一样,media_type 固定写 application/pdf,data 里只放 base64 字符串,PDF 放在问题前面。
方法二:用 URL 读取在线 PDF
PDF 已经在公网上时,直接给 URL:
{
  "type": "document",
  "source": {"type": "url", "url": "https://example.com/whitepaper.pdf"}
}
地址必须能从公网直接下载。需要登录才能访问的文件,请先下载到本地再用 base64 上传。
方法三:用 OpenAI SDK 上传 PDF(Python)
通过 SupaStore 的 OpenAI 兼容接口,也可以用 OpenAI SDK 的 file 内容类型上传 PDF,网关会把它转换成 Claude 的 document 格式:
import base64
from openai import OpenAI

client = OpenAI(
    base_url="https://api.supastore.cc/v1",
    api_key="sk-your-supastore-api-key",
)

with open("contract.pdf", "rb") as f:
    pdf_b64 = base64.b64encode(f.read()).decode()

resp = client.chat.completions.create(
    model="claude-sonnet-4-6",
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "file",
                "file": {
                    "filename": "contract.pdf",
                    "file_data": f"data:application/pdf;base64,{pdf_b64}",
                },
            },
            {"type": "text", "text": "找出合同中的付款条款、违约责任和终止条件"},
        ],
    }],
)
print(resp.choices[0].message.content)
Claude 读取 PDF 要多少钱
官方文档给出的经验值是:每页约 1,500~3,000 Token,取决于页面的内容密度,PDF 本身不额外收费。按这个范围估算一份 50 页的报告:
输入 Token:50 页 × 1,500~3,000 = 75,000~150,000
claude-sonnet-4-6 官方价 $3 / 百万 Token
读取一次 ≈ $0.23~$0.45(另加输出 Token)
想得到准确数字,最好的办法是发一次真实请求,看响应 usage 里的 input_tokens。
同一份 PDF 问多个问题:用缓存
对同一份 PDF 连续提问时,每次请求都会把整份 PDF 重新发送一遍。给 document 内容块加上 cache_control,后续请求命中缓存后,这部分只按缓存价计费:
{
  "type": "document",
  "source": {"type": "base64", "media_type": "application/pdf", "data": "..."},
  "cache_control": {"type": "ephemeral"}
}
以 claude-sonnet-4-6 为例,缓存命中价是普通输入的 1/10,同样 50 页的报告,后续每次提问的输入成本从 $0.23~$0.45 降到约 $0.023~$0.045。缓存的写法和命中条件见《Claude Prompt 缓存怎么用?》;成百上千份 PDF 的离线处理,可以用《Claude Batch API》再省一半。
长 PDF 处理技巧
- 只传需要的页面:一份 300 页的年报,往往只有财务报表那几十页有用,先用工具截取相关页面再上传;
- 超出页数上限就拆分:超过 600 页(或上下文窗口小于 1M 时超过 100 页)的文件,按章节拆成多个请求,最后再汇总;
- 问题写具体:明确要提取的字段、页码范围和输出格式,比"总结一下"得到的结果稳定得多;
- 要求标注出处:让 Claude 在每条结论后注明页码,方便人工核对;
- 扫描件优先保证清晰度:扫描件主要靠页面图像识别,分辨率太低会直接影响准确率。
Claude PDF 常见报错
| 现象 | 常见原因 | 处理方法 |
|---|---|---|
| 400,无法处理 PDF | PDF 加密或设置了密码 | 去掉密码保护后再上传 |
| 400,页数超限 | 超过 600 页,或上下文窗口小于 1M 时超过 100 页 | 拆分 PDF,分多次请求 |
| 413 请求过大 | 整个请求体超过 128 MB | 压缩 PDF、去掉无关页面 |
| 回答遗漏内容 | 页数太多,问题太笼统 | 缩小页码范围,问题写具体 |
更多错误码的含义见《Claude API 报错怎么办?》。
常见问题 (FAQ)
Q: Claude 能读取扫描版 PDF 吗?
答: 能。Claude 会把每一页渲染成图片再识别,所以没有文字层的扫描件也能读取,但清晰度越高,识别越准确。
Q: Claude 能读取 Word、Excel 文件吗?
答: Claude API 原生支持的文档格式是 PDF 和纯文本。Word、Excel 文件可以先导出为 PDF,或把内容转成文本、CSV 后再发送。
Q: 读取 PDF 和直接粘贴文字,哪个更省钱?
答: 直接粘贴纯文字更省,因为 PDF 的每一页还会额外计算页面图像的 Token。如果 PDF 里只有文字、没有表格和图表,先提取文字再发送可以明显降低成本。
Q: 一份 PDF 太大,超过上下文窗口怎么办?
答: 按章节拆分成多个请求分别处理,每个请求输出该部分的要点,最后再把各部分的要点合并,让 Claude 做一次总结。