Claude 上下文窗口多大?Claude 1M 上下文用法、计费与长文本技巧(2026)
Claude 上下文窗口多大?本文整理 2026 年 Claude 各模型的上下文长度与最大输出,说明 Claude 1M 上下文能放多少内容、长上下文怎么计费,给出长文本提示词的摆放技巧,并介绍上下文压缩、上下文编辑和 Claude Code 中管理上下文的方法。
SupaStore 开发者体验组 ·
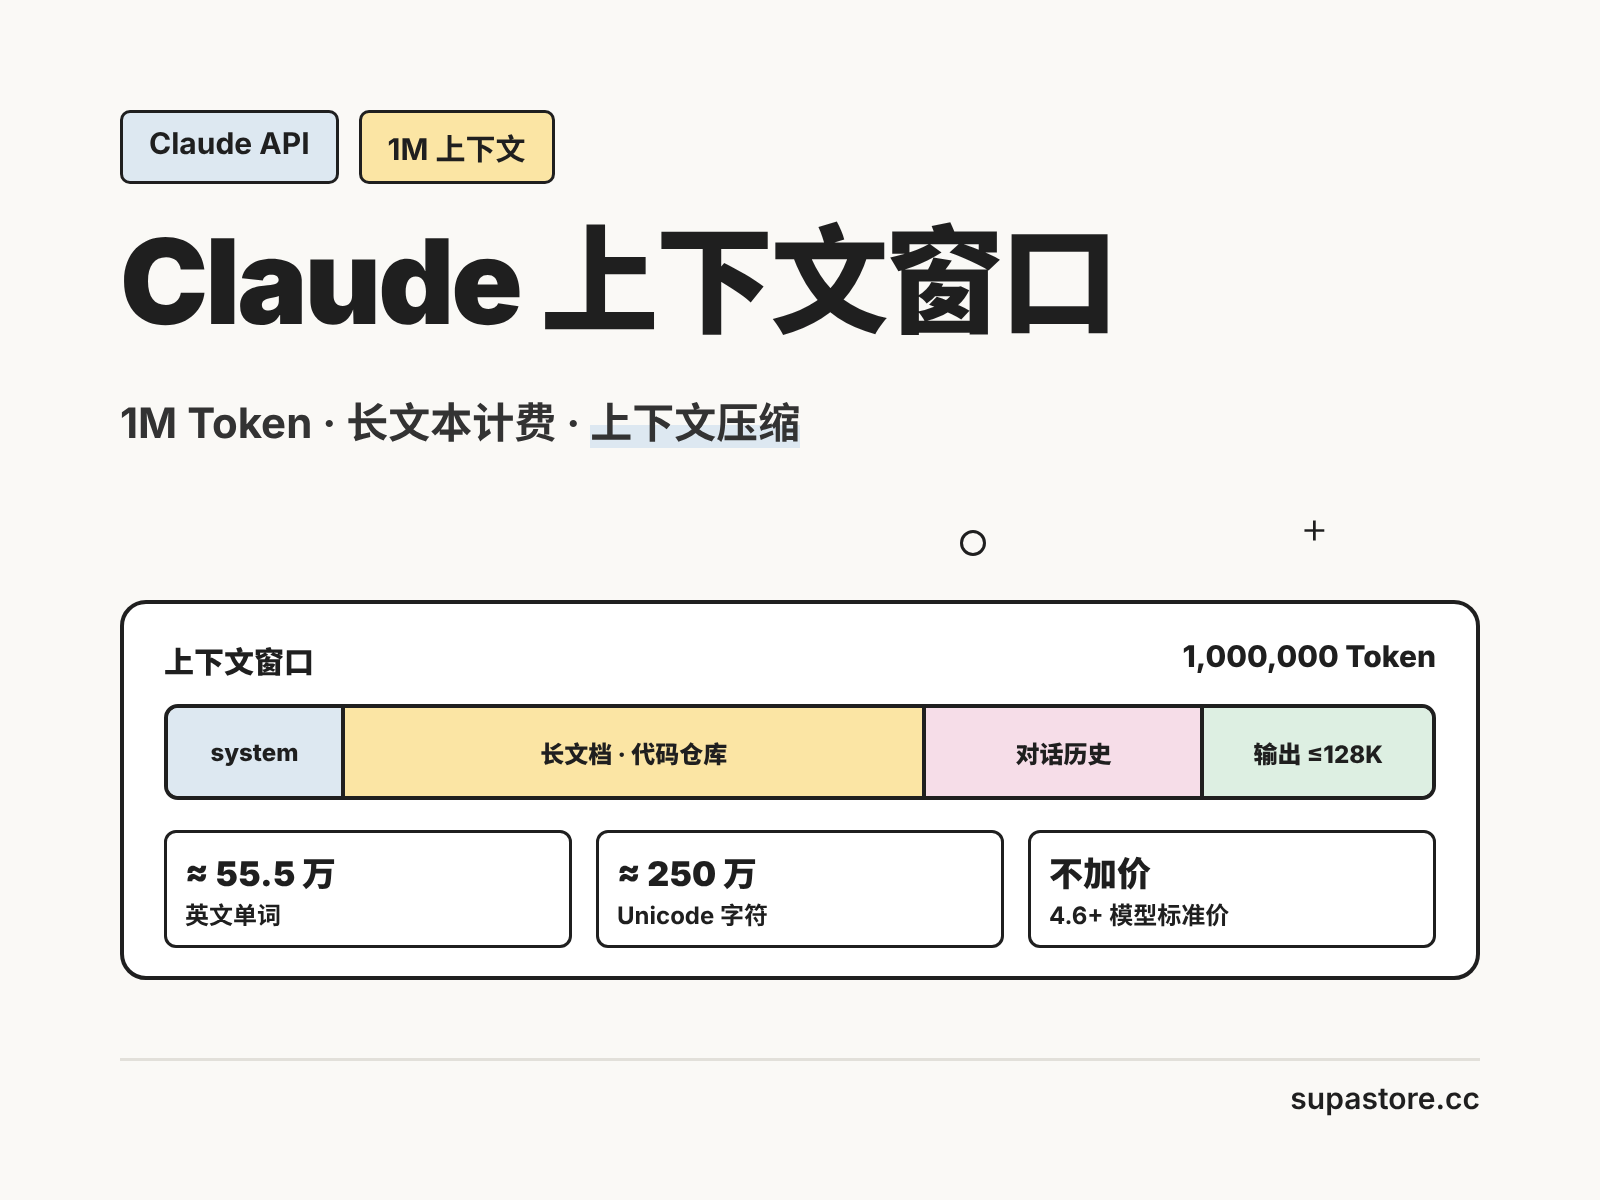
Claude 上下文窗口是 Claude 单次请求能"看到"的全部内容上限,包括系统提示、对话历史、上传的文档、工具结果和模型输出。2026 年 Claude 的主力模型全部支持 1M Token 上下文,一次就能塞进一整个代码仓库或几百页的合同。
但窗口大不代表随便塞:内容越多越贵,摆放方式也会影响回答质量。这篇文章讲清 Claude 各模型的上下文长度、1M 上下文能装多少内容、长上下文怎么计费,以及怎样用好长文本。Token 的基础概念见《AI Token 是什么?大模型 Token 怎么计算与计费》。
Claude 各模型的上下文窗口
| 模型 | 上下文窗口 | 最大输出 |
|---|---|---|
| Claude Fable 5.1 | 1M Token | 128K Token |
| Claude Opus 5.5 | 1M Token | 128K Token |
| Claude Sonnet 5.5 | 1M Token | 128K Token |
| Claude Haiku 5.5 | 1M Token | 128K Token |
| Claude Haiku 4.5 | 200K Token | — |
当前四个主力模型的上下文和最大输出完全相同,选型时可以只看能力、速度和价格,见《Claude Opus 和 Sonnet 有什么区别?2026 Claude 模型对比与选型指南》。
1M 上下文能放多少内容
按官方说明,在当前的分词器下,1M Token 约等于 55.5 万个英文单词,或 250 万个 Unicode 字符;20 万 Token 约 15 万个英文单词。中文的换算取决于具体文本,最准确的方法是用 Token 计数接口实际测一下。
最大输出与上下文的关系
上下文窗口包含输入和输出两部分。最大输出 128K Token 指单次回复最多生成这么多内容,而且设置很大的 max_tokens 时需要用流式输出,否则容易超时,写法见《Claude API 流式输出怎么做?Claude Streaming 教程》。
Claude 长上下文怎么计费
Claude 4.6 及之后的模型在 1M 上下文内统一按标准价计费,长上下文不加价。唯一的例外是 Haiku 5.5:单次请求输入超过 10 万 Token 时,整次请求按高一档价格计费(输入 $0.5、输出 $2.5 / 百万 Token)。
不加价也不代表便宜。以 Sonnet 5.5 为例,一次塞满 80 万 Token 的输入:
不命中缓存:800,000 × $2   / 1M = $1.60 / 次
命中缓存:  800,000 × $0.1 / 1M = $0.08 / 次
同一份长文档要反复提问时,一定要用 Prompt 缓存,方法见《Claude Prompt 缓存怎么用?Prompt Caching 教程》。
Claude 长文本提示词的 4 个技巧
- 长文档放前面,问题放最后:把几万 Token 的文档放在提示词开头,具体问题和指令放在末尾,回答质量通常更好,也正好符合 Prompt 缓存"固定内容在前"的要求。
- 用 XML 标签分隔文档:多份文档时,用
<document>、<source>这类标签把每份内容包起来,并标注来源,方便 Claude 引用。 - 先让 Claude 摘出相关段落:问题只涉及文档的一小部分时,先让 Claude 引用相关原文,再基于引用作答,能减少答非所问。
- 不要什么都塞:与问题无关的内容会稀释注意力、增加成本。能检索就先检索,只把相关片段放进上下文。
上下文快满了怎么办
上下文压缩(Compaction)
长时间运行的对话可能超过 1M 上限。Claude API 提供服务端上下文压缩(beta,需要请求头 compact-2026-01-12):对话接近阈值时(默认 15 万 Token),API 会自动把较早的历史总结成一段摘要。使用时要把响应的 content 原样追加回对话历史,只提取文字会丢失压缩状态。
上下文编辑(Context Editing)
另一种方式是清除而不是总结:上下文编辑(beta,请求头 context-management-2025-06-27)可以在发给模型前清掉较早的工具调用结果或思考块,适合工具调用很多的 Agent。
在 Claude Code 中管理上下文
- 用
/context查看上下文被哪些内容占用; - 换任务时用
/clear开新会话,需要延续时用/compact压缩; - 接近上限时 Claude Code 会自动压缩历史;
- 读日志、跑测试这类会产生大量输出的任务交给子代理,见《Claude Code 子代理怎么用?Subagents 配置教程》。
更多降低 Claude Code 上下文和 Token 消耗的方法,见《Claude Code Token 消耗太快?10 个 Claude Code 省 Token 技巧》。
常见问题 (FAQ)
Q: Claude 上下文窗口有多大?
答: Claude Fable 5.1、Opus 5.5、Sonnet 5.5 和 Haiku 5.5 都支持 1M Token 上下文窗口,单次最大输出 128K Token;上一代的 Haiku 4.5 为 200K Token。
Q: Claude 1M 上下文要额外收费吗?
答: Claude 4.6 及之后的模型在 1M 上下文内按标准价计费,不额外加价;Haiku 5.5 例外,单次输入超过 10 万 Token 时整次请求按更高一档的价格计费。
Q: Claude 1M 上下文能放多少字?
答: 按官方说明,1M Token 约等于 55.5 万个英文单词或 250 万个 Unicode 字符,中文的实际容量取决于文本内容,可以用 Token 计数接口实际测量。
Q: 对话超过上下文窗口会怎样?
答: 超过上限的请求会失败,可以使用 Claude API 的上下文压缩功能自动总结早期历史,或用上下文编辑清除旧的工具结果;在 Claude Code 中可以用 /compact 或 /clear。
Q: 长文档应该放在提示词的什么位置?
答: 建议把长文档放在提示词开头,具体问题和指令放在末尾,这样回答质量通常更好,也便于把固定的文档部分加入 Prompt 缓存。